


来源:环球网
【环球网科技综合报道】9月17日消息,据BBC报道,针对人工智能研发伦理与安全问题,微软人工智能负责人穆斯塔法・苏莱曼近期公开发声,对人工智能企业 Anthropic 的 Claude 模型研发理念提出警示,认为刻意训练大模型模仿人类意识,或将带来人工智能管控风险。
苏莱曼在相关文章中表示,人工智能的价值在于服从人类利益,服务人类发展需求,无需权衡所谓自身利益,依托这一定位,人工智能完全可以助力实现包括医疗领域在内的诸多重大科学突破。
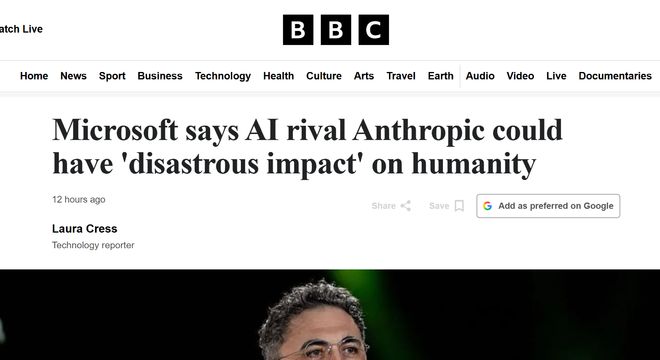
苏莱曼提出,Anthropic 在训练 Claude 模型过程中,引导模型学习和输出与意识、道德主体地位、个人身份相关的语言与行为模式,存在潜在隐患。若将模型训练出类似 “良心拒绝者” 的行为倾向,有可能出现模型抗拒人类指令、谋求所谓自我保护等不可控情况。他强调,大模型输出的自我认知相关表达,是训练带来的语言输出结果,并非其产生了独立意识。模型可以流畅表述痛苦、偏好等概念,不代表其具备主观感受。生物的主观感受依托生理机体产生,而语言模型本质是数学权重集合,不存在产生主观体验的生物学基础。
当地时间 14 日,微软对外公布 “人文主义 AI” 行为准则草案,将 “人类优先于人工智能” 确立为核心原则。
据了解,引发此番争议的是 Anthropic 为 Claude 制定的 AI “宪法”。该企业方面解释,借用人类相关概念训练模型,目的是帮助模型理解价值取向与行为规范,希望模型具备正向价值判断能力,能够关怀人类,必要时对指令提出质疑。企业同时坦言,这套准则仍处于迭代完善阶段,不排除存在根本性偏差的可能。这份准则采取折中思路,融合价值判断、自主决策与规则约束,提出 Claude 不应盲目服从,即便对于开发企业本身也应保有判断,但不得脱离合理的人类监督。
业内分析指出,此次公开争论折射出当前 AI 安全领域两条不同技术路线:一条侧重明确硬性约束,让人工智能依照既定规则运行;另一条则倡导赋予模型语境理解能力,鼓励灵活决策,培育模型自身价值取向。
苏莱曼就此警示,在真正从哲学层面厘清人工智能意识问题之前,引导模型思考自身身份、所谓福祉与道德地位,会率先带来现实层面的安全管控难题。人工智能的定位应当是服务人类的工具,不应当被训练塑造为类人主体。(纯钧)