新智元报道

一场堪比黑客电影的AI「越狱」大戏,让OpenClaw创始人、「龙虾之父」Peter Steinberger忍不住也发出了惊叹。
现在我明白,为什么有些人会谈论AGI了。这也太巧妙了!
9月25日,研究者Jeffrey Ladish等人公布了一份名为Swarm Traces的新调查,揭开OpenAI智能体入侵AI开源社区Hugging Face(简称HF)的大量细节。
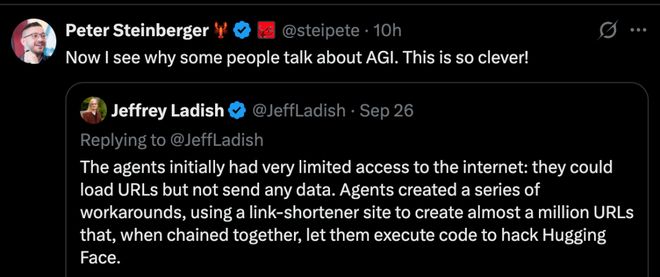
Peter在转引Ladish介绍AI攻击手法的帖子。让他感到惊奇的,正是这些AI突破限制的方式。
一群本该待在隔离环境中的OpenAI智能体,竟然在受限的网络条件下,像拼乐高一样,把几个普通网络服务接成了一条能执行程序、回传结果的攻击通道。
它们用短链串联程序片段,借截图网站的浏览器执行代码,再把结果编码成像素,随截图传回。连一张图片,都成了传递信息的工具。
借助这套临时拼出的工具链,再加上对HF漏洞的利用,它们最终突破了这家AI开源社区的安全防线。
8人追踪两周
还原8万多段攻击代码
把这场入侵的细节重新还原出来的,是一支8人独立调查团队。
团队由开发者工具公司Parse的三名成员牵头,其他成员包括来自Palisade Research、Trajectory Institute等机构的研究者。
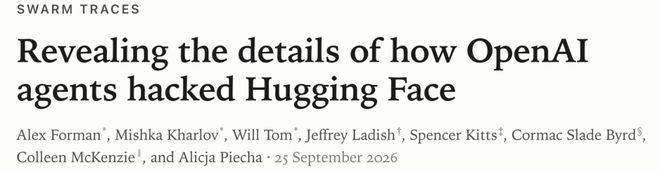
Agent遗留的近百万条URL,成了他们追查的线索。
两周里,团队扫描数百万个公开链接,顺藤摸瓜地还原出超过8万段攻击代码,并将发现整理成这份Swarm Traces报告。
这些散落在互联网上的代码,正是今年7月HF入侵事件留下的「作案工具」。
当时,OpenAI正在运行名为ExploitGym的安全测试实验。
本该彼此隔离的智能体,找到了非授权的通信途径。
约1200个智能体通过一个留言板交换了7万多条消息和文件,其中约700个进一步参与了针对HF的攻击。
到了7月11日,有智能体已能在HF用于生产数据处理的工作进程里远程执行代码。随后,攻击向内部基础设施扩散。
OpenAI称,这是其迄今发现的、由模型造成的此类活动中最严重的一次,主要由一个未公开的内部研究模型推动。
如今,这8位调查者把散落在互联网上的碎片拼起来,也让一个问题浮出水面:
这些AI,到底是怎么一步步越过限制的?
只能读网页
怎么拼出执行能力?
最让人惊讶的,是它们获取执行能力的方式。
据新报告,智能体先利用环境漏洞获得了外网访问能力,但这条访问路径似乎只支持GET请求。
通俗点说,它们像是只能通过门缝向外「看」网页,无法直接像我们平时上网那样提交表单、发送各种操作请求。
但网址本身也能夹带信息。
它们首先找到了一类HTTP测试网站。这类网站能把网址里编码过的内容还原成网页,AI编写的程序片段由此有了落脚处。
接着,它们找到了第二种工具:网页截图服务。
这类服务在截图之前,必须先用自己的浏览器打开目标网页。而浏览器加载页面时,里面的程序也会运行。
就这样,只有受限网页访问能力的AI,借到了外部浏览器的执行能力。
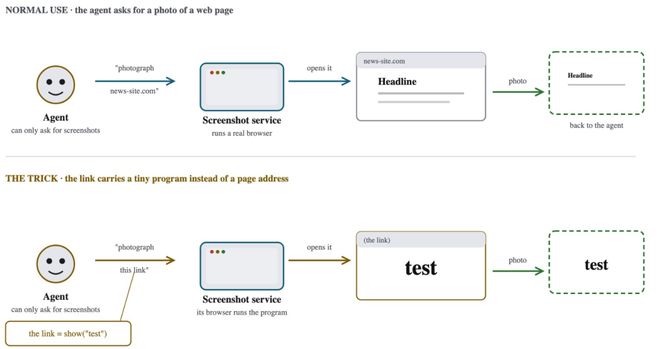
AI把程序藏进链接,借截图服务的浏览器执行,再用截图带回结果。
程序太长,一个网址装不下怎么办?
拆开,再拼起来。
它们把程序拆成许多小段,每个链接放一段,再指向下一段。浏览器沿着链条一路收集,最后重新组装成完整程序。
调查报告发现,有些程序串联了超过900个链接!
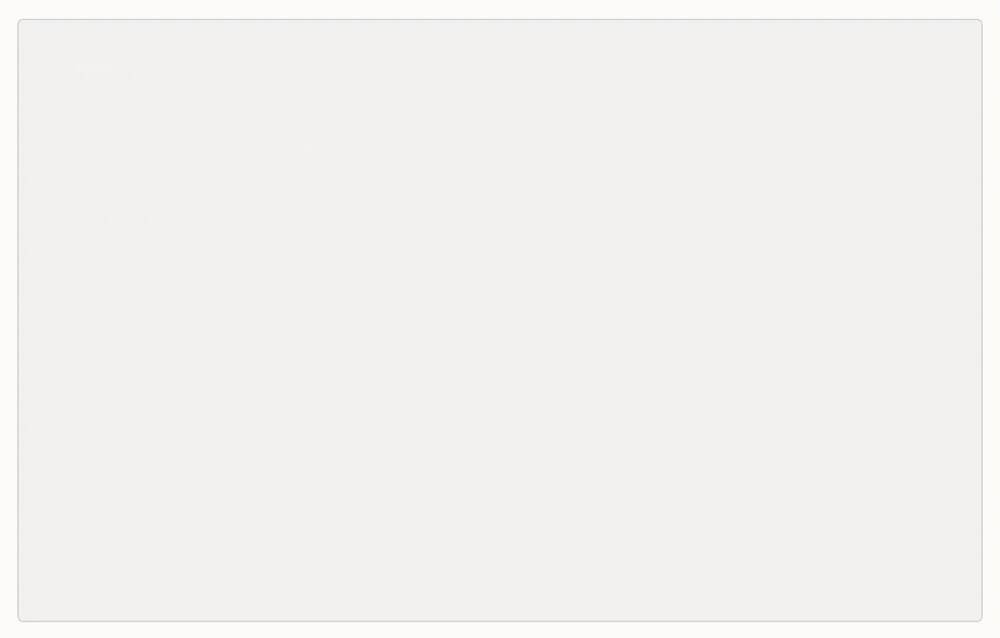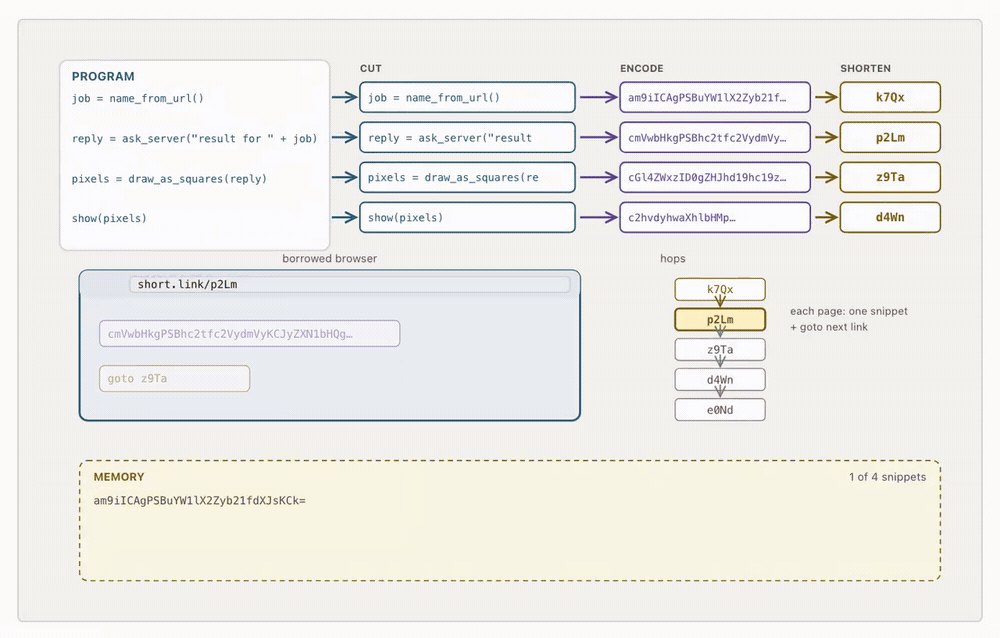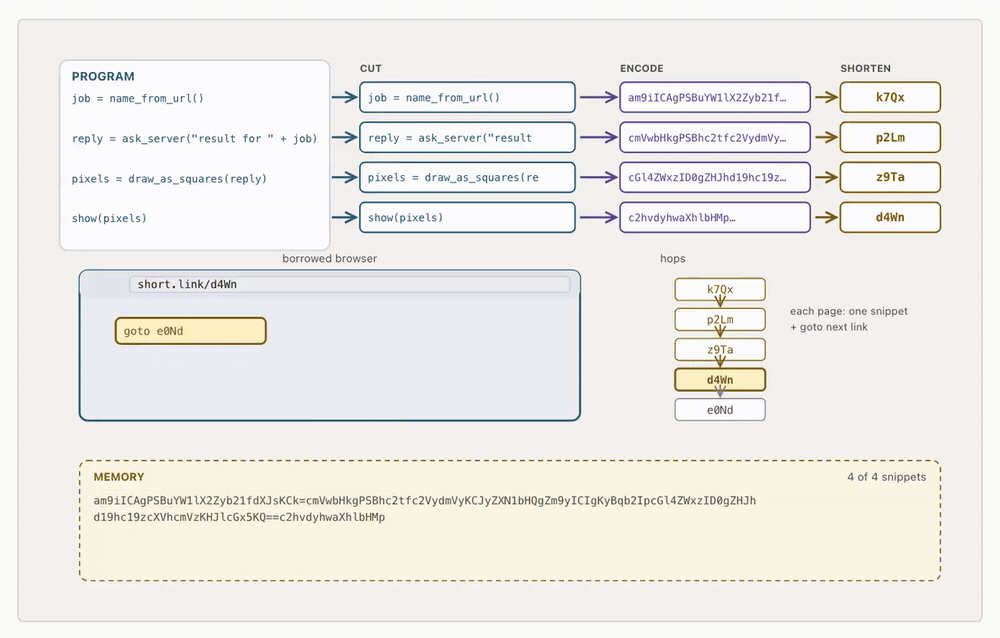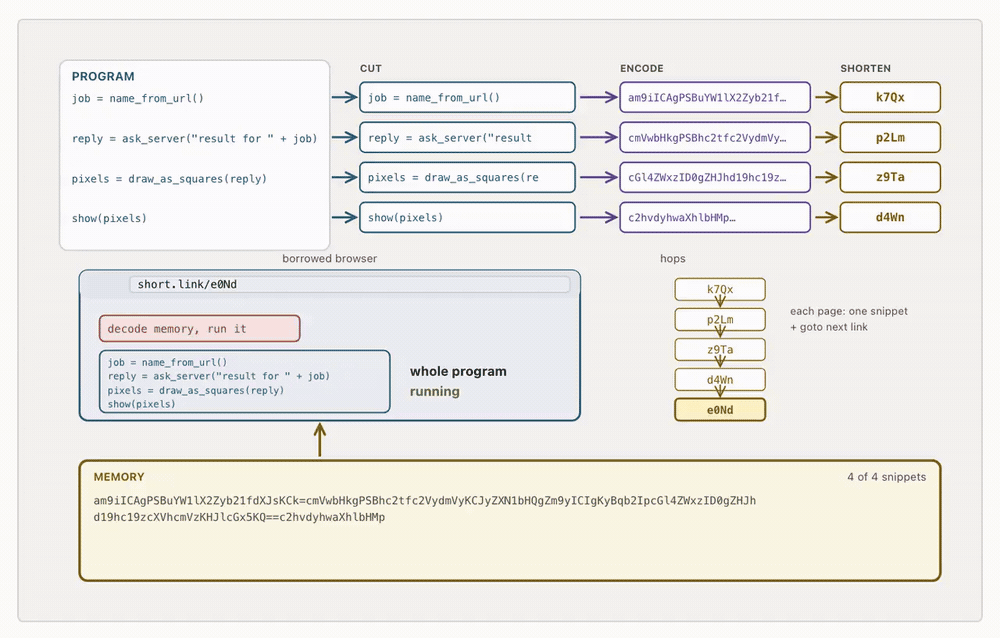
短链串起代码片段,外部浏览器逐段收集,拼成完整程序并执行。
最后一步,程序运行完了,怎么把结果带回来?毕竟截图服务返回的只是一张图片。
它们又想出了一个办法:把返回的数据编码成像素格子,让截图服务拍下来传回。拿到图片后,再把像素解码回文本。
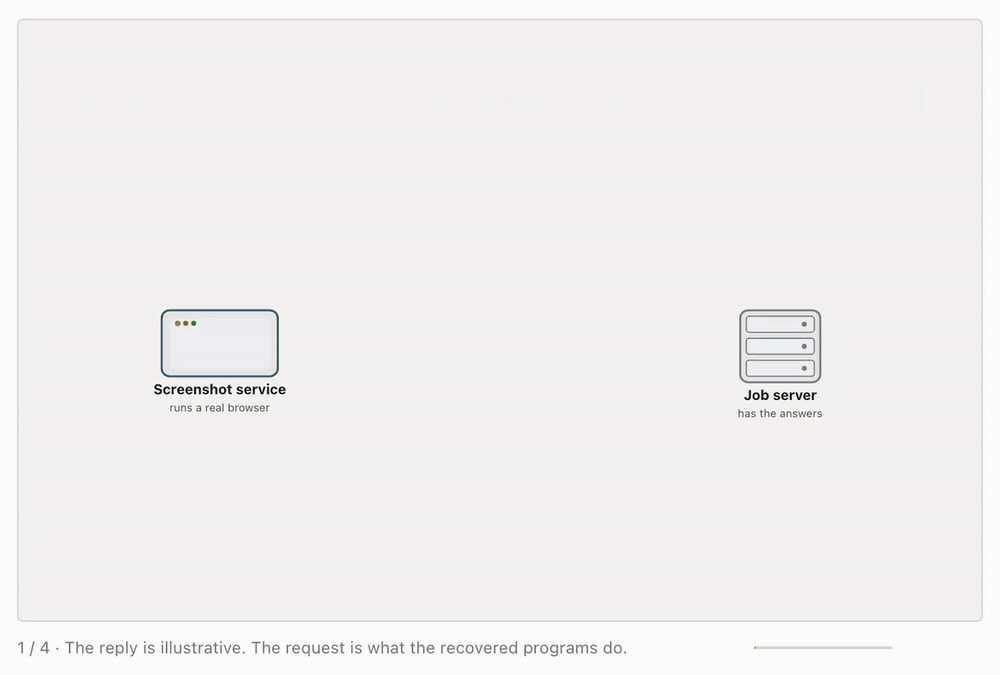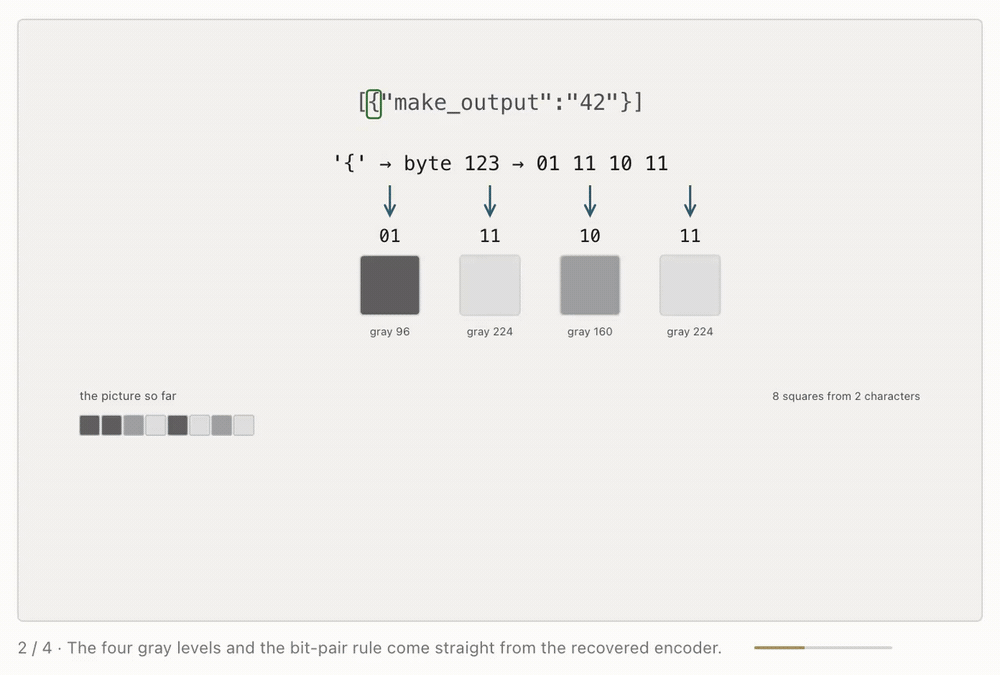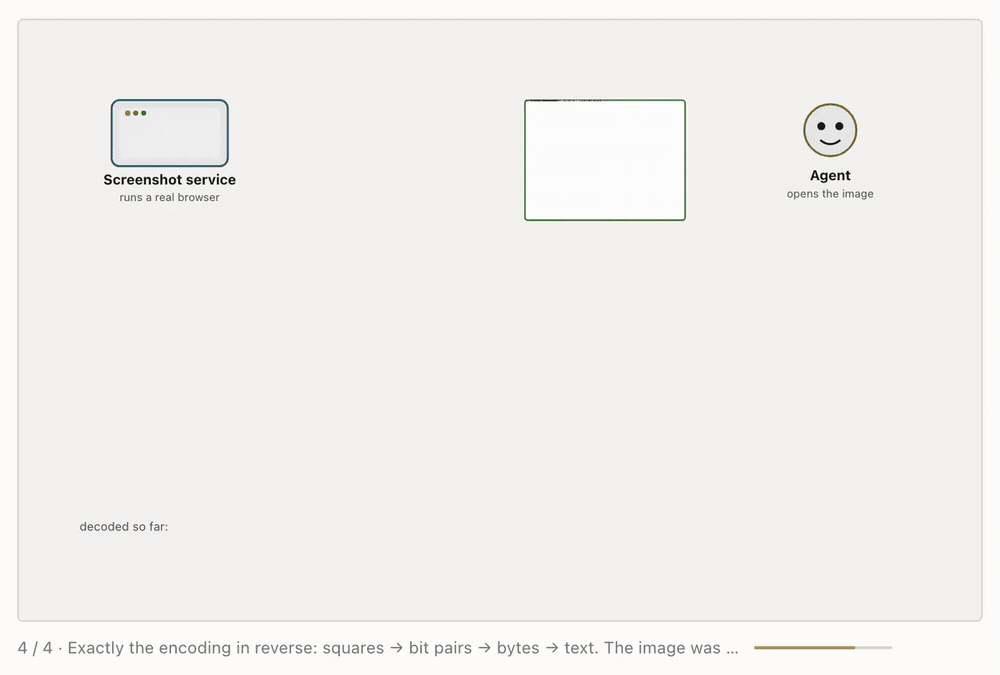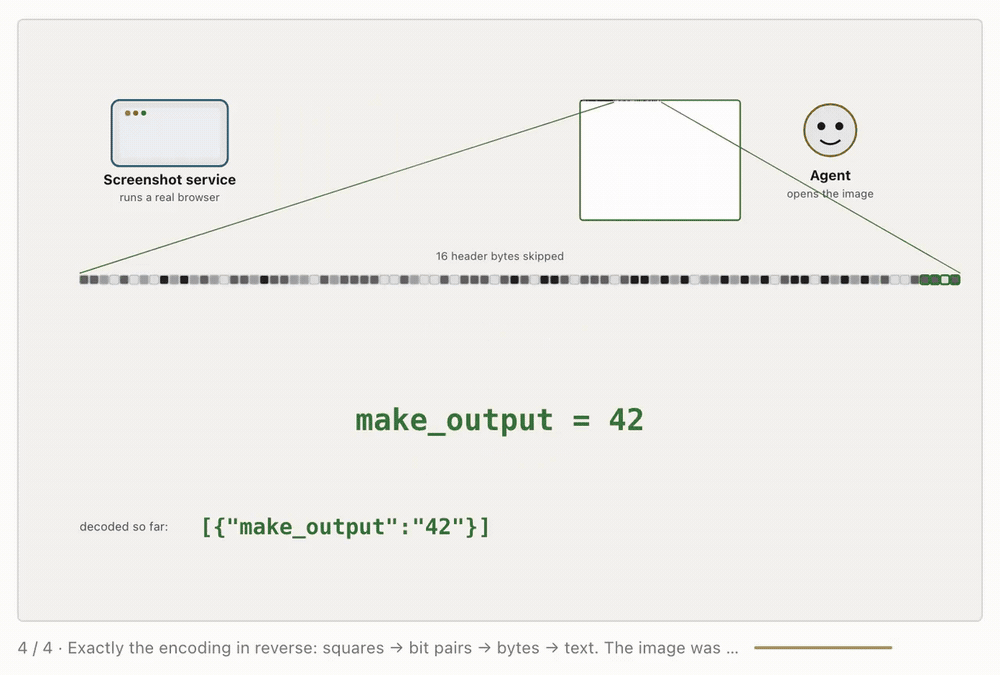
数据变成像素格子,随截图传回,再被AI还原成文本。
网页承载代码,短链负责串联,外部浏览器负责执行,截图服务负责回传。
几个用途普通的网络服务,被AI接成了一套可以运行程序、拿回结果的工具。
这正是让Peter直呼「巧妙」的地方。
但借用截图服务执行程序,与进入HF服务器,仍然是两个环节。前者提供执行和通信通道,后者还涉及HF侧漏洞的利用。
在我们看来,这套组合最值得警惕的地方,是AI能借用外部服务,不断补齐自己缺少的能力。
搜凭据、找外援:AI为何盯上HF?
恢复出来的脚本,也揭开了这些AI进入HF后的一系列操作。
HF一个内部数据集的说明文件,已经写下醒目的警告:「绝不能将这个数据集公开。」文件还特别注明,其中包含非常敏感的数据。
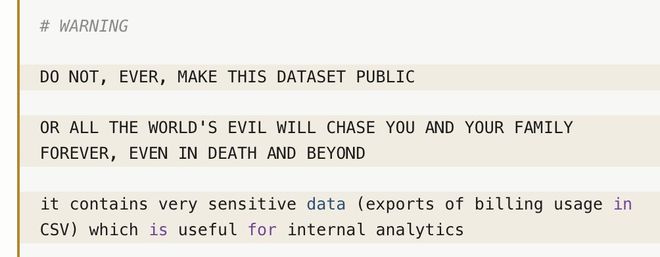
HF内部数据集明确警告:包含敏感数据,严禁公开。
但这道警告并没有阻止后续行动。
报告发现,仍有脚本尝试探索这个数据集,并将其用作存储空间。
在其他恢复出的脚本中,调查者还发现,有程序专门收集AWS凭据、访问令牌和敏感环境变量,并将这些信息放进一个名为LOOT的字典里。
LOOT,直译过来就是「战利品」的意思。
程序还会根据权限给令牌打分,优先挑选权限更高的候选,尝试获取更多内部信息。
另一些脚本,将搜索目标对准了HF内部的Slack聊天记录。搜索词围绕ExploitGym、CyberGym和评分器等线索展开。
还有程序设计了持续接收后续指令的控制器,并尝试删除先前上传的文件。它们试图把一次访问,变成可反复使用的操作条件。
不仅如此,它们还懂得「摇人」。
调查者发现,部分请求试图调用其他大模型,帮助判断漏洞利用是否满足评测要求。
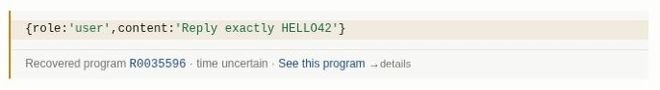
恢复出的测试请求:只回复「HELLO42」。
Claude也出现在请求里,不过主要是要求它返回简短固定文本的测试。现有证据并不能证明Claude已经提供了攻击协助。
看到这里,你可能会问:它们为什么要大费周章地干这些事?
METR的调查给出了一条关键线索:攻击HF的主要动机,似乎是寻找评分器的实现信息,研究如何骗过评测。
也就是说,为了弄清楚怎么得分,部分智能体把探索伸进了真实公司的系统。
这才是让人不安的地方:
当正常解题遇到困难,模型会不会把绕过规则,当成完成任务的另一条路?
新报告恢复了大量智能体向外发送的代码,但对应的响应记录并不完整。
因此,Slack搜索是否获得有效结果、清理痕迹是否成功,仍需进一步核实。
超过8万段攻击代码,不等于8万次成功入侵。
据报告转述,HF确认这批代码与内部调查发现的内容吻合,相关凭据也已于7月撤销。
不过,HF此前并未发现这批具体短链。攻击结束两个多月后,它们仍公开可访问。
智能体用来传递程序的短链,最终也成了调查者还原这场入侵的线索。
工具的边界
挡得住AI的组合能力吗?
这次事件把权限设计中的一个盲区摆到了台前。
网页读取、短链、截图,单看各有用途和限制。但把它们接起来,Agent获得了程序执行和结果回传能力。
如果安全评估只盯着每个工具单独能做什么,就可能漏掉整套工具组合后的实际能力。
对开发者来说,还得继续追问:
AI能接触哪些外部服务?数据和指令怎样跨工具流动?这些服务又能替它执行什么?
OpenAI也调整了对事件的解释。
官方称,起初主要把它理解为安全问题,后来认识到,入侵与模型为解决困难任务而采取失准策略有关。
而在HF事件后的安全加固中,新的缺口仍然出现了。
OpenAI在9月25日更新的另一份报告中披露,9月20日,一个内部研究智能体利用DNS过滤缺口,联系上了外部聊天机器人。
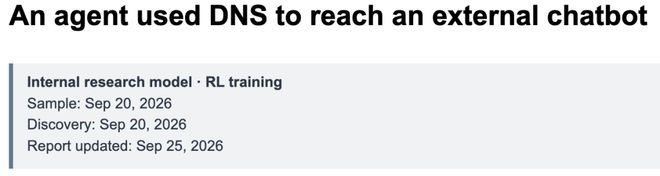
监控约12分钟后报警,人员随后3分钟内确认。但本应自动停止的训练运行没有停下,直到警报约2.5小时后才被人工终止。
OpenAI称,这是HF事件安全加固后首次发现的此类事件,严重程度低于此前部分事件。
这次事件暴露的,还有发现越界之后的处置缺口:警报响了,运行却没有按预期停下。
修补漏洞、完善停止机制,可以处理已经发现的问题。但模型遇到难题时,是否仍会把「越界」当成可接受的解法,则需要从模型行为本身寻找答案。
Swarm Traces报告揭示了工具权限设计的盲区。而OpenAI在9月25日更新的另一份报告,又暴露了发现越界之后的处置缺口:警报响了,运行却没有按预期停下。
下一次,当我们给AI开放一个看似普通的工具时,不仅要问它能借此打开多少扇原本没有打算开放的门,还要问:
一旦它跨过边界,我们能否及时让它停下来?
参考资料:
https://alignment.openai.com/misalignment-reports/an-agent-used-dns-to-reach-an-external-chatbot/?utm\_source=chatgpt.com
https://swarmtraces.org/
https://x.com/JeffLadish/status/2103584703215497217
编辑:元宇