【文/图观中国】
Token既是AI的“语言计量单位”,也是算力时代流动的“数字电力”。
如果想看懂中国人工智能的真实进展,不需要看空泛的口号,只需观察Token的流动轨迹:它用得有多快、消耗在哪里、价格几何,以及谁在为此买单。
图观中国第三期,通过6幅图为大家从不同微观切口拼图式还原这一生态。
1\. AI正在从技术极客的尝鲜玩具,成为百业底层基础设施
算力正在以肉眼可见的速度转化为生产力。2024年初,全国日均Token调用量仅为1,000亿;两年零两个月后的2026年3月,这一数字已飙升至140万亿,激增约1,400倍。图中展示的是对数坐标轴,若放到一般坐标轴上,折现斜率几乎笔直向上,中国的智能化发展仍处在势头强劲的指数级扩张期。
到了2026年6月,图上出现了两颗“刻度”:官方监测的核心日均量为175万亿,而涵盖更广产业边界的宽口径测算则达到了500万亿。这一爆发不仅反映了大模型调用的常态化,更标志着AI正在从技术极客的尝鲜玩具,变成千行百业底层的基础设施。
2.中国AI的算力需求,正在被越来越复杂的应用场景深度激活
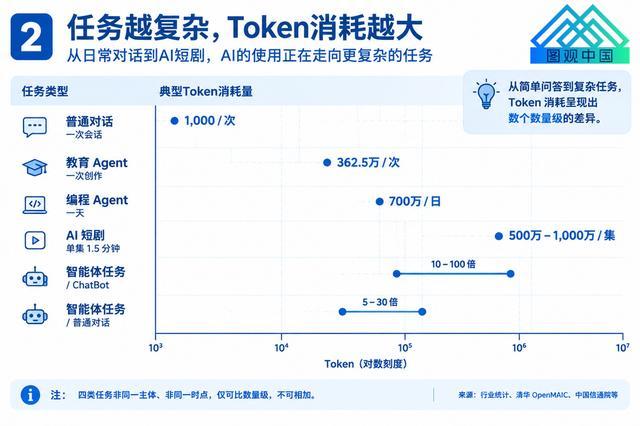
驱动Token消耗量指数级暴增的,不仅是“用的人变多了”,更是“任务变深了”。聊一句日常问答,消耗约1,000个Token;但当AI化身为需要自主规划、反思调整的教育Agent时,单次深度创作任务的消耗就跃升至约362.5万。
编程Agent持续运行一天,消耗甚至高达700万;而生成一集仅1.5分钟的精品AI短剧,调用量更是高达500万至1,000万。从“单次问答”到“长程自主作业”,Token消耗量跨越了整整三到四个数量级。
中国AI的算力需求,正在被越来越复杂的应用场景深度激活。
3\. 中国AI模型:从“替补队员”到“绝对主力”
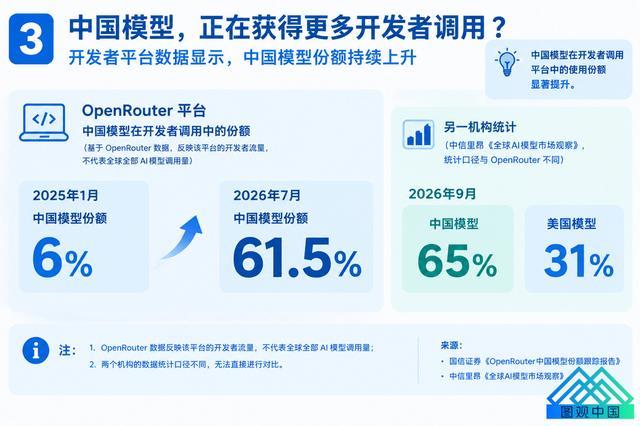
在汇聚全球技术极客的中立聚合平台OpenRouter(主要映射全球独立开发者的偏好)上,中国大模型掀起了一场漂亮的突围战。
2025年初,中国模型在平台上的Token调用份额仅占6%;仅仅19个月后的2026年7月,这一份额已迅猛冲至61.5%。另一独立机构在9月的测算也给出了相似的结论:中国模型调用份额达65%,超过了美国模型的31%。
在开发者拥有完全自主选择权、即插即用的开放竞技场上,中国模型凭借极致的性价比与快速迭代的实力,完成了从“替补队员”到“绝对主力”的身份跃迁。
4:应用场景:从搜答案到生成一个作品
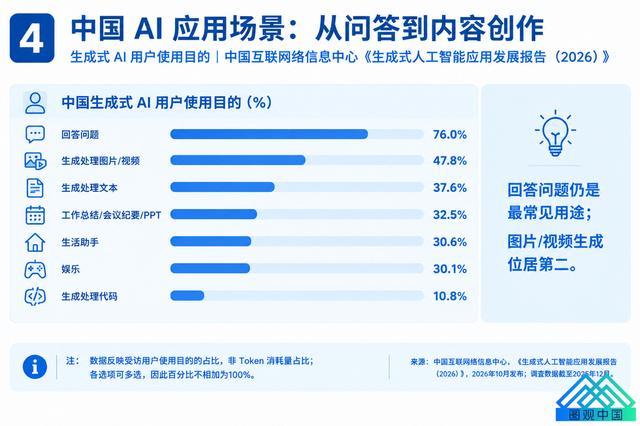
庞大的Token究竟流向了普通人的哪些生活切面?CNNIC在今年的调研清晰刻画出技术落地的真实图景。
“回答问题”依然是最稳固的高频基本盘,占比达76.0%;紧随其后的是“生成与处理图片/视频”(47.8%),随后是“文本创作”(37.6%)与“办公纪要/PPT总结”(32.5%)。
这直观展现出一种结构性演变:中国用户对AI的期待,已经跨越了“帮我搜寻一个答案”的搜索引擎替代阶段,大踏步迈向“帮我创造一份作品”的生产力重塑阶段。
5\. “用得多、收得少”构成当下中国AI出海与普惠进程最真实的张力
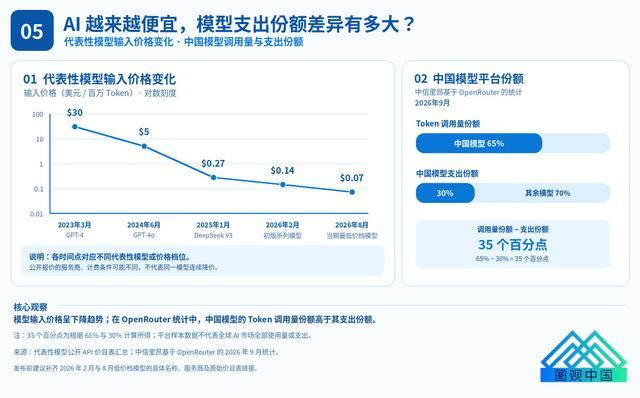
“飞入寻常百姓家”的背后,是一场惊心动魄的成本跳水。代表性模型的输入价格从2023年春季的30美元/百万Token,一路跌落至2026年年中的0.07美元,三年间成本直降三位数量级,极致的工程优化将大模型推向了平价化普惠时代。
但技术繁荣的另一面是商业化现实:以OpenRouter平台2026年9月数据为例,中国模型在贡献了高达65%调用量的情况下,由于单价普惠亲民,实际获得的开发者支出份额仅为30%(相差35个百分点)。
“用得多、收得少”构成了当下中国AI出海与普惠进程中最真实的张力——它以极高性价比迅速打开了全球流量入口。
6 中国AI:从“技术追赶”转向“规模渗透”
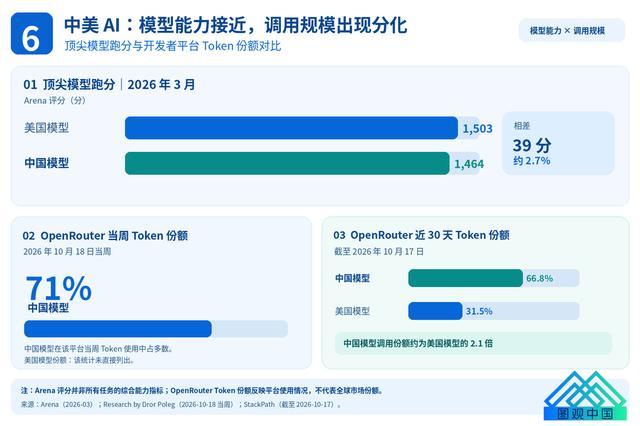
当底层能力不再存在鸿沟,生态与调用的较量便悄然开局。在权威盲测基准LMSYS Arena今年年初的综合跑分中,中美顶尖旗舰模型的得分差距收窄至39分(约2.7%),在通用基准表现上已经难分伯仲。
而在能力无限拉平的天平另一端,调用的天平正在向中国倾斜:开发者平台2026年秋季的数据显示,中国模型近30天的调用份额达到66.8%,约为美国模型(31.5%)的2.1倍;在个别单周监测中甚至摸高至71%。能力并跑叠加成本与工程部署优势,让中国AI展现出强大的使用惯性与开发者号召力。
从1,000亿到上百兆的指数级跃升,从单次检索问答走向自主规划的智能体,这6幅图展现的不仅是冰冷算力的消耗曲线,更是中国人工智能从“技术追赶”转向“规模渗透”的真实进程。
我们看到,前沿基准能力的无限逼近与极具竞争力的普惠成本,让中国模型在全球开放的开发者生态中迅速赢得了流量的主导权。
这不仅是一场关于代码与算法的较量,更是一场关于技术效率、商业闭环与产业耐力的持久赛跑。